Google dan Anthropic Dukung Standar Baru Pengaturan Konten Situs untuk Pelatihan AI
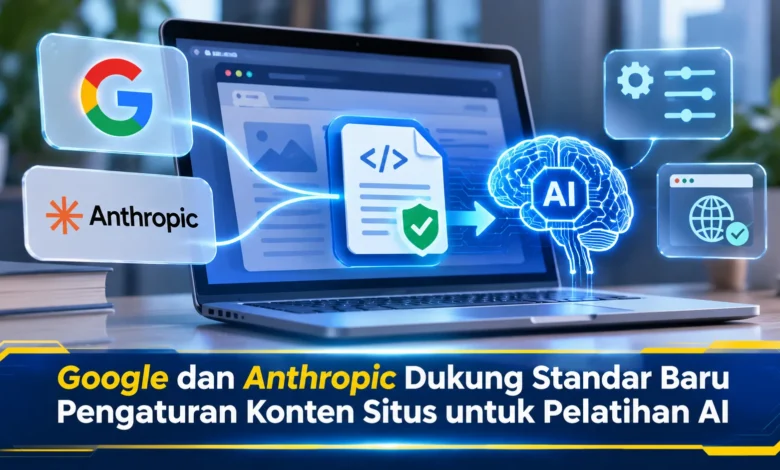
Google dan Anthropic menyatakan dukungan terhadap pendekatan baru yang memberikan kontrol lebih besar kepada pemilik situs web dalam menentukan penggunaan konten mereka untuk pelatihan kecerdasan buatan. Pada 30 Oktober 2026, sejumlah perusahaan TEKNOLOGI terkemuka mendukung proposal pengaturan bersama melalui file robots.txt yang sedang dibahas dalam lingkungan Internet Engineering Task Force (IETF). Inisiatif ini bertujuan menyederhanakan cara penerbit digital menyampaikan izin atau penolakan terhadap penggunaan konten untuk melatih model AI. Dengan pendekatan tersebut, pengelola website tidak perlu terus bergantung pada aturan berbeda untuk setiap penyedia AI, meskipun penerapannya masih membutuhkan pengembangan dan kesepakatan lebih lanjut.
Perusahaan Teknologi Mengembangkan Standar Penggunaan Konten Website
Inisiatif baru dalam ekosistem teknologi digital menunjukkan meningkatnya perhatian terhadap hak pengelola website. Google dan Anthropic mengumumkan dukungan terhadap proposal pengaturan bersama yang membantu pemilik situs menyampaikan preferensi penggunaan konten untuk pelatihan AI. Inisiatif tersebut juga memperoleh komitmen dari Microsoft dan OpenAI. Sasaran pengembangan ini adalah meringkas proses pengelolaan izin dengan menggunakan sinyal yang dapat dipahami oleh berbagai penyedia AI. Dalam praktik yang sudah berjalan, pengelola website sering perlu mengatur instruksi berbeda untuk setiap robot pengumpul data. Berkat rancangan tersebut, proses pengaturan diharapkan menjadi semakin praktis tanpa menghilangkan pilihan pengaturan khusus.
Partisipasi berbagai penyedia teknologi menandai perkembangan yang penting karena penggunaan data internet memiliki peran besar dalam pengembangan model kecerdasan buatan. Sejumlah pengembang memanfaatkan informasi dari sumber yang tersedia secara publik untuk mendukung proses pengembangan teknologi. Namun, penerbit konten juga mengharapkan kemampuan untuk mengatur bagaimana karya mereka dapat digunakan. Berkat dukungan terhadap sinyal preferensi bersama, penerbit berpotensi menyampaikan keputusan secara lebih jelas. Meskipun begitu, dukungan terhadap proposal tidak berarti seluruh perusahaan telah mengaktifkan mekanisme tersebut secara serentak. Penerapan nyata masih dipengaruhi oleh jadwal pengembangan masing-masing perusahaan serta perkembangan pembahasan standar.

Cara Kerja Standar Baru melalui File Robots.txt
Pendekatan pengendalian bersama menggunakan file robots.txt yang secara umum digunakan untuk menyampaikan instruksi kepada robot perayap website. File tersebut biasanya disimpan pada direktori utama domain agar dapat dibaca oleh sistem otomatis. Pada mekanisme baru tersebut, pengelola situs dapat menambahkan token kebijakan bernama __usage_ai-training untuk menyatakan preferensi terkait pelatihan AI. Untuk memberikan gambaran, pemilik website dapat mengatur agar seluruh konten tidak digunakan untuk pelatihan model generatif. Sebagai pilihan tambahan, aturan juga dapat diatur untuk direktori tertentu sesuai kebutuhan. Kemampuan tersebut memberikan pilihan yang lebih terstruktur dibandingkan pengelolaan instruksi terpisah bagi setiap penyedia AI.
Ketentuan mendasar yang perlu dipahami adalah perbedaan antara preferensi penggunaan data untuk pembelajaran model dan pemblokiran akses website secara keseluruhan. Mekanisme preferensi ini ditujukan untuk menyampaikan keputusan tentang penggunaan konten dalam pelatihan AI, bukan otomatis meniadakan keberadaan halaman dari hasil pencarian internet. Dengan demikian, pemilik situs dapat menentukan kebijakan yang berbeda antara kebutuhan ditemukan pengguna dan pemanfaatan konten untuk pengembangan model. Namun, cakupan pengaturan dapat tidak selalu sama menurut interpretasi masing-masing penyedia layanan. Google, misalnya, menyatakan akan menerapkan sinyal penolakan bersama sebagai pengaturan Google-Extended apabila tidak terdapat instruksi khusus yang menyatakan sebaliknya. Dengan mempertimbangkan kondisi tersebut, pengelola website tetap sebaiknya memahami kebijakan setiap perusahaan sebelum menerapkan aturan.
Hubungan Standar Baru dengan Google-Extended dan Robot AI Lainnya
Sebelum adanya proposal bersama, sejumlah perusahaan AI menyediakan mekanisme tersendiri untuk membatasi penggunaan konten website. Google, misalnya, menyediakan Google-Extended sejak 2023 sebagai kontrol terhadap penggunaan konten dalam layanan AI tertentu. Sebagai pendekatan berbeda, Anthropic mengoperasikan robot seperti ClaudeBot yang digunakan dalam pengumpulan konten untuk pengembangan model. Pengaturan terpisah menawarkan fleksibilitas, tetapi juga menambah pekerjaan bagi pengelola situs yang harus mempelajari berbagai kebijakan teknis. Pendekatan standar industri dirancang untuk meringankan kebutuhan tersebut. Dengan satu sinyal, pemilik website direncanakan dapat menyampaikan preferensi umum kepada penyedia AI yang ikut mendukung mekanisme tersebut.
Walaupun menawarkan kemudahan, pengaturan khusus masing-masing perusahaan masih dapat digunakan. Artinya, pengelola situs dapat menggunakan kebijakan umum sekaligus menyampaikan pengecualian bagi penyedia tertentu. Google menjelaskan bahwa instruksi Google-Extended yang disebutkan secara eksplisit akan tetap digunakan dalam mekanisme pengaturannya. Pendekatan ini membantu penerbit menentukan keputusan yang lebih sesuai dengan kebutuhan mereka. Dalam situasi tertentu, sebuah situs mungkin ingin menolak penggunaan kontennya untuk sebagian layanan AI tetapi tetap memberikan akses bagi layanan tertentu. Meskipun begitu, konsekuensi pengaturan tersebut harus dipahami berdasarkan dokumentasi setiap perusahaan karena istilah pelatihan, pencarian, dan penggunaan konten dalam jawaban AI tidak selalu memiliki cakupan identik.
Peluang Perlindungan Karya Digital dalam Ekosistem Kecerdasan Buatan
Untuk pemilik situs internet, kehadiran standar pengaturan bersama berpotensi meningkatkan kendali atas penggunaan konten. Dalam pengelolaan konten digital, perusahaan media, blogger, dan pemilik platform informasi menerbitkan berbagai materi yang membutuhkan waktu, biaya, serta tenaga kreatif. Ketika informasi tersebut digunakan dalam proses pengembangan model AI, pemilik konten dapat memiliki pertimbangan terkait izin, atribusi, dan manfaat ekonomi. Melalui sistem preferensi yang lebih jelas, penerbit dapat mengomunikasikan apakah konten mereka boleh digunakan untuk tujuan pelatihan. Pilihan tersebut tidak otomatis menjamin kompensasi finansial atau perlindungan hukum menyeluruh, tetapi dapat berfungsi sebagai sarana komunikasi kebijakan yang lebih mudah dikenali oleh penyedia teknologi.
Untuk keberlanjutan ekosistem internet, mekanisme pengaturan konten juga dapat memfasilitasi hubungan yang lebih transparan antara penerbit dan pengembang AI. Perusahaan teknologi membutuhkan beragam informasi untuk meningkatkan kemampuan sistem. Sementara itu, penerbit ingin memastikan bahwa karya mereka digunakan sesuai kebijakan yang telah ditentukan. Pengaturan yang lebih seragam dapat membantu komunikasi antara kedua pihak tersebut. Namun, efektivitas pendekatan ini dipengaruhi oleh kepatuhan penyedia layanan dan kejelasan implementasi teknis. Ketika semakin banyak perusahaan mendukung mekanisme serupa, pengelola website dapat mendapatkan proses administrasi yang lebih sederhana tanpa harus mengatur banyak instruksi individual secara terus-menerus.
Perkembangan Proposal IETF Menuju Pengaturan Konten Bersama
Meskipun memperoleh komitmen, proposal pengaturan konten untuk pelatihan AI masih memiliki beberapa tantangan sebelum dapat diterapkan secara menyeluruh. Tantangan utama adalah perbedaan jadwal implementasi antarpengembang. Google menyatakan akan mengupayakan dukungan terhadap sinyal bersama pada 2027. Microsoft menetapkan rencana mulai menghormati pengaturan tersebut pada 1 Februari 2027. Sementara itu, OpenAI menjelaskan rencana penerapan dalam beberapa bulan setelah pengumuman, sedangkan Anthropic telah memulai pekerjaan implementasi. Perbedaan waktu tersebut berarti pemilik situs tidak dapat langsung menyimpulkan bahwa setiap penyedia AI telah mengikuti sinyal bersama dengan cara yang sama. Pada tahap pengembangan, instruksi khusus perusahaan tetap relevan bagi pengelola yang ingin mempertahankan kebijakan pembatasan konten.
Tantangan berikutnya berkaitan dengan status standardisasi dan kepatuhan terhadap instruksi website. Proposal yang sedang dibahas berada dalam lingkungan kerja AI Preferences atau AIPREF di Internet Engineering Task Force, tetapi belum menjadi standar internet final. Tahapan standardisasi masih melibatkan masukan dari berbagai pemangku kepentingan. Di samping itu, robots.txt pada dasarnya digunakan sebagai sarana penyampaian instruksi yang kepatuhannya dipengaruhi oleh perilaku robot pengakses situs. File tersebut bukan sistem yang secara teknis dapat menghentikan seluruh pihak mengambil konten. Sinyal preferensi tersebut juga tidak secara otomatis menarik kembali data yang telah dikumpulkan sebelumnya. Oleh sebab itu, pengelola website tetap dianjurkan untuk memahami bahwa kebijakan konten, pengendalian akses, dan perlindungan hukum merupakan aspek yang berbeda.
Penutup dan Prospek Standar Pengaturan Konten AI
Keterlibatan Google, Anthropic, Microsoft, dan OpenAI terhadap standar pengaturan konten bersama menjadi perkembangan berarti dalam mendorong ekosistem kecerdasan buatan yang lebih memperhatikan pilihan penerbit. Berkat penerapan token kebijakan dalam robots.txt, pemilik website memiliki kesempatan untuk mengatur preferensi pelatihan AI secara lebih sederhana. Meskipun demikian, pengaturan tersebut masih berada dalam tahap pengembangan dan memerlukan dukungan teknis dari berbagai perusahaan agar dapat digunakan dengan efektif. Masa depan pendekatan ini akan ditentukan oleh kepatuhan penyedia AI, kejelasan standar, dan kebutuhan penerbit digital. Dari sudut pandang Anda, apakah pengaturan bersama seperti ini akan memberikan kendali lebih besar kepada pemilik website? Bagikan pandangan Anda mengenai perkembangan teknologi pengaturan konten untuk pelatihan AI.