Tips Mengoptimalkan GPU untuk AI di 2026, Atur Memory hingga Batch Size agar Lebih Efisien
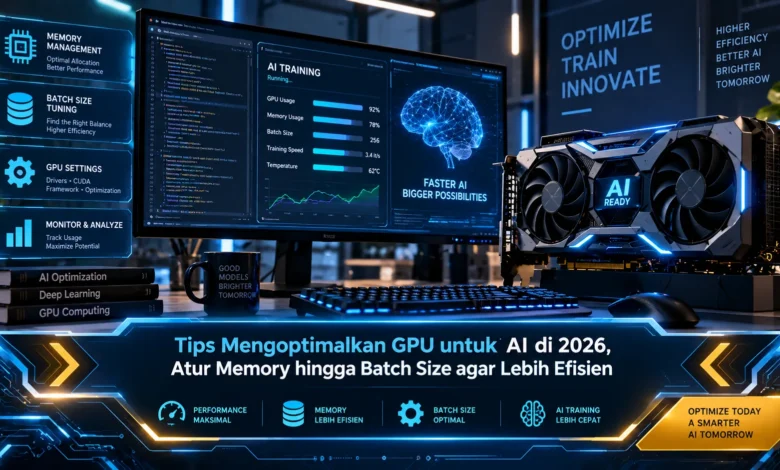
Penggunaan GPU untuk menjalankan workload AI pada 2026 semakin beragam, mulai dari inference model lokal, generative AI, hingga training dan fine tuning. Namun, GPU yang cepat belum tentu memberikan hasil optimal jika VRAM, batch size, precision, dan alokasi memory tidak dikonfigurasi dengan tepat. Dalam perkembangan TEKNOLOGI AI yang semakin intensif terhadap komputasi, memahami cara mengoptimalkan sumber daya GPU menjadi langkah penting agar performa tetap tinggi tanpa memboroskan kapasitas perangkat.
Kenali Kebutuhan GPU dan VRAM Sebelum Menjalankan AI
Tahap awal untuk meningkatkan efisiensi GPU pada workload AI adalah memahami kebutuhan model yang akan digunakan. Setiap model AI memiliki kebutuhan komputasi dan memory yang berbeda, sehingga konfigurasi yang cocok untuk satu model belum tentu ideal untuk model lainnya. Model dengan jumlah parameter tinggi umumnya membutuhkan VRAM lebih banyak daripada model dengan jumlah parameter lebih kecil.
Pengguna juga perlu membedakan kebutuhan training dan inference. Proses pelatihan umumnya membutuhkan VRAM tambahan untuk activation, gradient, parameter, serta state optimizer, sedangkan inference umumnya memiliki kebutuhan memory yang lebih sederhana. Dengan memahami perbedaan tersebut, konfigurasi GPU dapat disusun secara lebih efisien.
Manajemen VRAM Menjadi Kunci Optimasi GPU AI
Pengaturan kapasitas memori grafis memiliki peranan besar dalam menentukan stabilitas proses komputasi. Kapasitas VRAM tidak hanya dikonsumsi oleh ukuran model, tetapi juga dipakai untuk activation, cache, tensor sementara, serta berbagai operasi komputasi. Oleh sebab itu, menjalankan model hingga VRAM hampir penuh dapat meningkatkan risiko kehabisan memory pada tahap berikutnya.
Salah satu strategi yang dapat diterapkan adalah mempertahankan sebagian kapasitas VRAM agar tetap tersedia. Monitoring memory dapat dilakukan sepanjang proses komputasi untuk mengidentifikasi operasi yang memberikan tekanan terbesar terhadap VRAM. Apabila software lain turut memakai akselerasi grafis, menonaktifkan program yang tidak dibutuhkan bisa meningkatkan kapasitas memory yang tersedia untuk menjalankan workload AI secara lebih stabil.
Batch Size yang Tepat Membantu Menjaga Efisiensi
Pengaturan jumlah data per batch sangat berpengaruh pada penggunaan memory sekaligus kecepatan pemrosesan. Batch yang semakin besar biasanya membutuhkan VRAM lebih banyak, meski berpotensi memberikan throughput yang lebih tinggi ketika kapasitas hardware mencukupi. Di sisi lain, batch yang terlalu kecil dapat membuat kemampuan GPU tidak dimanfaatkan secara optimal.
Pendekatan yang lebih efektif ialah menguji beberapa ukuran batch sembari memperhatikan konsumsi memory. Saat memory GPU mulai terpakai dalam jumlah tinggi, pengguna dapat memilih ukuran batch sebelumnya sebagai konfigurasi yang lebih stabil. Apabila kapasitas GPU tidak memungkinkan penggunaan batch besar, gradient accumulation dapat dimanfaatkan untuk mengakumulasi hasil dari beberapa langkah agar proses training dapat menyerupai penggunaan batch lebih besar tanpa membutuhkan seluruh VRAM sekaligus.
Precision yang Tepat Membuat Komputasi AI Lebih Efisien
Format numerik merupakan salah satu faktor utama dalam mengatur efisiensi workload kecerdasan buatan. Memproses semua operasi dengan precision yang lebih berat bisa membuat konsumsi VRAM menjadi lebih besar ketika sebenarnya sebagian operasi dapat dijalankan menggunakan format yang lebih ringan. Oleh sebab itu, penggunaan precision campuran menjadi pendekatan menarik untuk optimalisasi GPU.
Representasi numerik seperti FP16 maupun BF16 berpotensi menekan konsumsi VRAM dibandingkan menjalankan seluruh komputasi dalam FP32. Pada GPU yang mendukung akselerasi format tersebut, throughput dapat bertambah karena GPU mampu menjalankan komputasi dengan lebih efektif. Walaupun begitu, dukungan hardware dan framework perlu diperiksa terlebih dahulu sehingga penggunaan TEKNOLOGI tersebut tetap memberikan hasil yang sesuai.
Optimasi Model Membantu GPU Menjalankan Workload Lebih Besar
Teknik quantization merupakan pendekatan yang berguna saat pengguna ingin menjalankan model yang lebih besar pada GPU terbatas. Metode tersebut menyimpan bobot model menggunakan format yang lebih ringkas, sehingga kebutuhan kapasitas memori grafis menjadi lebih rendah. Model dengan precision numerik yang lebih rendah sering dimanfaatkan untuk membuat inference model besar lebih ringan.
Tidak hanya melalui pengurangan precision model, teknik checkpointing maupun offloading dapat digunakan sesuai dukungan software yang tersedia. Teknik checkpointing activation mampu menekan konsumsi memory dengan menghitung ulang sebagian data ketika diperlukan. Pendekatan tersebut dapat memberikan fleksibilitas ketika ukuran model mendekati batas kemampuan perangkat, meski efisiensi memory terkadang harus dibayar dengan proses yang sedikit lebih lambat.
Optimalkan Framework dan Pantau Bottleneck GPU
Meningkatkan efisiensi GPU tidak semata bergantung pada spesifikasi perangkat, melainkan turut ditentukan oleh perangkat lunak, driver, library komputasi, serta framework. Versi driver dan framework yang sesuai mampu membuat berbagai optimasi hardware digunakan secara maksimal. Sebaliknya, ketidaksesuaian software dapat membuat sebagian kemampuan GPU tidak termanfaatkan.
Pemantauan performa sebaiknya dilakukan ketika model sedang diproses agar bottleneck dapat ditemukan dengan lebih mudah. Jika utilisasi GPU rendah sementara CPU bekerja sangat tinggi, masalah mungkin berada pada pipeline data atau preprocessing. Jika GPU bekerja tinggi tetapi VRAM selalu penuh, pengaturan batch, format numerik, alokasi memory, serta model perlu dievaluasi. Pendekatan berbasis pengukuran lebih efektif dibandingkan sekadar menebak konfigurasi terbaik.
Kesimpulan
Meningkatkan efisiensi GPU AI pada 2026 bukan sekadar mengejar utilisasi tinggi tetapi juga mengatur memory dan workload secara tepat. Pengaturan VRAM, pemilihan batch, penggunaan precision campuran, optimasi model, serta evaluasi bottleneck mampu membuat sumber daya GPU dimanfaatkan secara lebih optimal. Setiap jenis proses AI memiliki pola penggunaan sumber daya yang tidak sama, sehingga pengujian konfigurasi secara bertahap tetap menjadi langkah yang penting.
Perkembangan TEKNOLOGI AI yang semakin cepat menjadikan optimalisasi sumber daya sebagai kebutuhan yang semakin relevan. GPU dengan kapasitas besar memang memberikan ruang lebih luas, meski demikian optimasi tetap diperlukan agar sumber daya tidak terbuang. Melalui pemahaman mengenai memory GPU, konfigurasi model, precision, dan pola komputasi, developer dapat menjalankan workload AI dengan penggunaan sumber daya yang lebih terkendali. Pembaca dapat mencoba setiap optimasi secara bertahap sambil mencatat perubahan performa untuk menemukan konfigurasi yang paling sesuai.