Unified Memory AI Workstation Ubah Cara Menjalankan Model AI Besar Tanpa GPU Terpisah
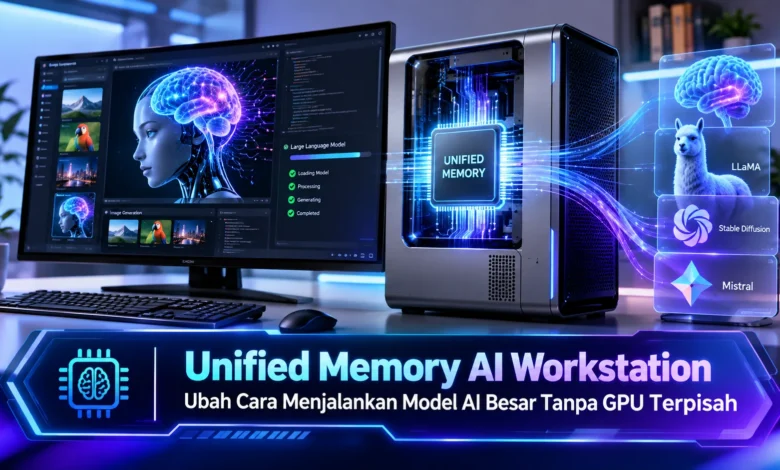
Unified Memory AI Workstation mulai menghadirkan pendekatan berbeda dalam menjalankan model kecerdasan buatan berukuran besar secara lokal. Alih alih selalu mengandalkan kartu grafis diskret dengan VRAM terpisah, arsitektur unified memory memungkinkan CPU, GPU terintegrasi, dan unit pemrosesan lain pada sistem yang mendukung untuk mengakses kumpulan memori bersama. Perkembangan teknologi ini menarik perhatian karena kapasitas memori yang besar dapat membuka ruang untuk menjalankan model AI yang sebelumnya sulit dimuat pada perangkat dengan VRAM terbatas, meskipun performa nyata tetap dipengaruhi bandwidth memori, kemampuan komputasi, optimasi perangkat lunak, serta karakter model yang digunakan.
Unified Memory Menghadirkan Pendekatan Baru untuk Workstation AI
Arsitektur memori bersama menghadirkan konsep yang berbeda dibandingkan sistem komputasi konvensional yang memisahkan RAM sistem dan VRAM. Pada sistem unified memory yang mendukung, komponen komputasi yang kompatibel dapat menggunakan kumpulan memori yang sama untuk memproses workload.
Konsep semacam ini semakin relevan untuk komputasi model AI secara lokal karena sistem AI yang kompleks sering membutuhkan jumlah memori yang signifikan. Apabila unified memory memiliki kapasitas yang luas, model yang sulit dimuat pada VRAM terbatas bisa menjadi lebih memungkinkan untuk dimuat tanpa harus menggunakan GPU diskret dengan VRAM sangat besar.
Model AI Besar Membutuhkan Memori yang Semakin Luas
Kapasitas memori menjadi faktor utama ketika developer mencoba mengoperasikan model kecerdasan buatan yang kompleks. Bobot model perlu dimuat ke dalam memori agar aplikasi AI dapat menghasilkan keluaran. Makin kompleks model yang digunakan, dapat semakin meningkat kapasitas yang diperlukan.
Metode seperti kuantisasi berpotensi mengurangi kebutuhan memori dengan mengoptimalkan representasi parameter. Namun, RAM bersama dengan kapasitas tinggi tetap menawarkan ruang tambahan untuk mengoperasikan AI lokal dengan kebutuhan tinggi. Evolusi teknologi workstation menjadikan ukuran unified memory menjadi bagian utama dari kebutuhan komputasi AI modern.
GPU Terintegrasi Tetap Berperan dalam Unified Memory Workstation
Konsep tidak menggunakan GPU diskret sebaiknya tidak disalahartikan. Perangkat dengan arsitektur memori bersama tetap dapat memiliki unit pemrosesan grafis terintegrasi untuk memproses workload tertentu. Perbedaannya, akselerator grafis terintegrasi tidak harus memiliki kumpulan memori terpisah dari RAM utama.
Dengan demikian, kemampuan menjalankan model AI besar bukan berarti proses komputasi dapat berjalan tanpa akselerator. Kekuatan akselerator, kecepatan perpindahan data, dukungan framework, dan jenis quantization tetap berperan dalam kecepatan inferensi. Integrasi hardware dan software menentukan hasil akhir dalam mengoptimalkan teknologi kecerdasan buatan di perangkat.
Performa AI Tidak Hanya Ditentukan oleh Jumlah RAM
Memiliki unified memory besar dapat memberikan keuntungan dalam menampung parameter model, tetapi jumlah RAM semata tidak otomatis memberikan performa AI tinggi. Selama inferensi model, sistem harus membaca parameter serta informasi melalui jalur memori.
Kecepatan memori yang memadai dapat membantu mengurangi hambatan perpindahan data pada proses inferensi yang bergantung pada memori. Sebaliknya, workload yang memiliki kapasitas RAM mencukupi belum tentu berjalan dengan sangat cepat apabila subsistem pemrosesan menjadi hambatan. Developer yang menentukan perangkat karena itu idealnya mengevaluasi keseluruhan spesifikasi memori dan komputasi.
AI Lokal Membuka Workflow Baru untuk Developer dan Kreator
Pemrosesan kecerdasan buatan pada perangkat sendiri menghadirkan pilihan penggunaan yang lebih luas bagi developer. LLM yang dijalankan di perangkat dapat dimanfaatkan untuk membantu coding, menganalisis informasi, membantu pencarian pengetahuan, hingga melakukan eksperimen kecerdasan buatan.
Kreator juga dapat memperoleh manfaat teknologi AI lokal untuk workflow visual, pemrosesan suara, dan workflow generatif lainnya yang telah dioptimalkan untuk hardware tersebut. Pemrosesan lokal juga dapat mengurangi frekuensi pengiriman pekerjaan ke server eksternal, meskipun layanan daring masih memiliki peran untuk kebutuhan komputasi yang melampaui kemampuan perangkat lokal.
AI Lokal Berkapasitas Besar Semakin Mudah Diakses
Perkembangan unified memory menggambarkan bahwa pemrosesan kecerdasan buatan lokal tidak lagi selalu perlu mengandalkan kartu grafis terpisah. Sistem dengan memori bersama menghadirkan alternatif untuk mengalokasikan memori secara lebih fleksibel dalam sistem yang lebih ringkas.
Meski demikian, pemilihan perangkat tetap perlu diselaraskan dengan jenis model. Workstation dengan memori terpadu dapat menawarkan fleksibilitas memori yang menarik, sedangkan kartu grafis khusus berperforma tinggi dapat tetap lebih sesuai untuk komputasi dengan kebutuhan throughput tinggi. Evolusi teknologi komputasi pada akhirnya membuka alternatif baru kepada developer untuk memilih arsitektur berdasarkan workload.
Kesimpulan Menjalankan Model AI Besar dengan Unified Memory
Workstation AI dengan memori terpadu menawarkan alternatif baru untuk mengoperasikan kecerdasan buatan secara lokal tanpa harus bergantung pada kartu grafis terpisah. Kapasitas memori bersama yang besar mampu menyediakan ruang bagi workload dengan kebutuhan memori tinggi, tetapi bandwidth, daya pemrosesan, dan optimalisasi software tetap menjadi faktor utama. Evolusi workstation AI tersebut memperluas pilihan bagi pengguna AI lokal yang ingin membawa lebih banyak pemrosesan AI ke perangkat sendiri. Sampaikan pandangan Anda mengenai masa depan workstation AI dan jenis model apa yang ingin Anda jalankan secara lokal.